第五篇的奖励是一个学出来的标量。它可以被 hack:分数上涨,人的偏好下降。数学答案对不对、测试通不通过,可以由规则检查。这一篇从这份可验证奖励写起。Tulu 3 把这种设定叫做 RLVR。GRPO 是 DeepSeekMath 里相对 PPO 的简化,不是「有了验证器就自动有了推理」。
o1 只作为推理时用更多计算换正确率的现象。它的训练步骤没有公开,这里不写。
范围:结果可验证的推理 RL。对照 GRPO、DeepSeek-R1 的多阶段配方、DAPO,以及 2025 年对这套训练的三组批评和修正。过程奖励只写到 R1 报告自己放弃它的理由。
一、验证器换掉的是 RM,不是信用分配
结果奖励是稀疏的 0/1。它不再经过 Bradley-Terry,也绕开「RM 分数和真实偏好分叉」。代价是整段长 CoT 只有结尾一个比特,中间步骤的对错没有单独的梯度。
Lightman 等 用逐步对错训练过程奖励模型,用来重排或引导搜索。DeepSeek-R1 的「不成功的尝试」写了他们为什么没有把 PRM 放进大规模 RL:细粒度步骤很难定义,自动标注不可靠,人工标注扩不了规模;一旦奖励来自模型,就会回到 Gao 等人的 reward hacking,还要再训一次 RM。MCTS 同样被放下:token 的分支比棋盘大,价值模型又直接决定搜索质量,他们没有把 AlphaGo 那条迭代做稳。报告说这些方法不是不可能,只是在他们的实验里,相对开销不值。R1-Zero 用的是规则:数学看最终答案,代码看测试,另加格式奖励,不用神经网络的过程奖励。
二、GRPO 去掉 Critic,KL 仍在损失里
PPO 用 Critic 把回报变成优势。GRPO 对同一道题采样一组回答,用组内奖励的均值和标准差做优势,Critic 没有了。
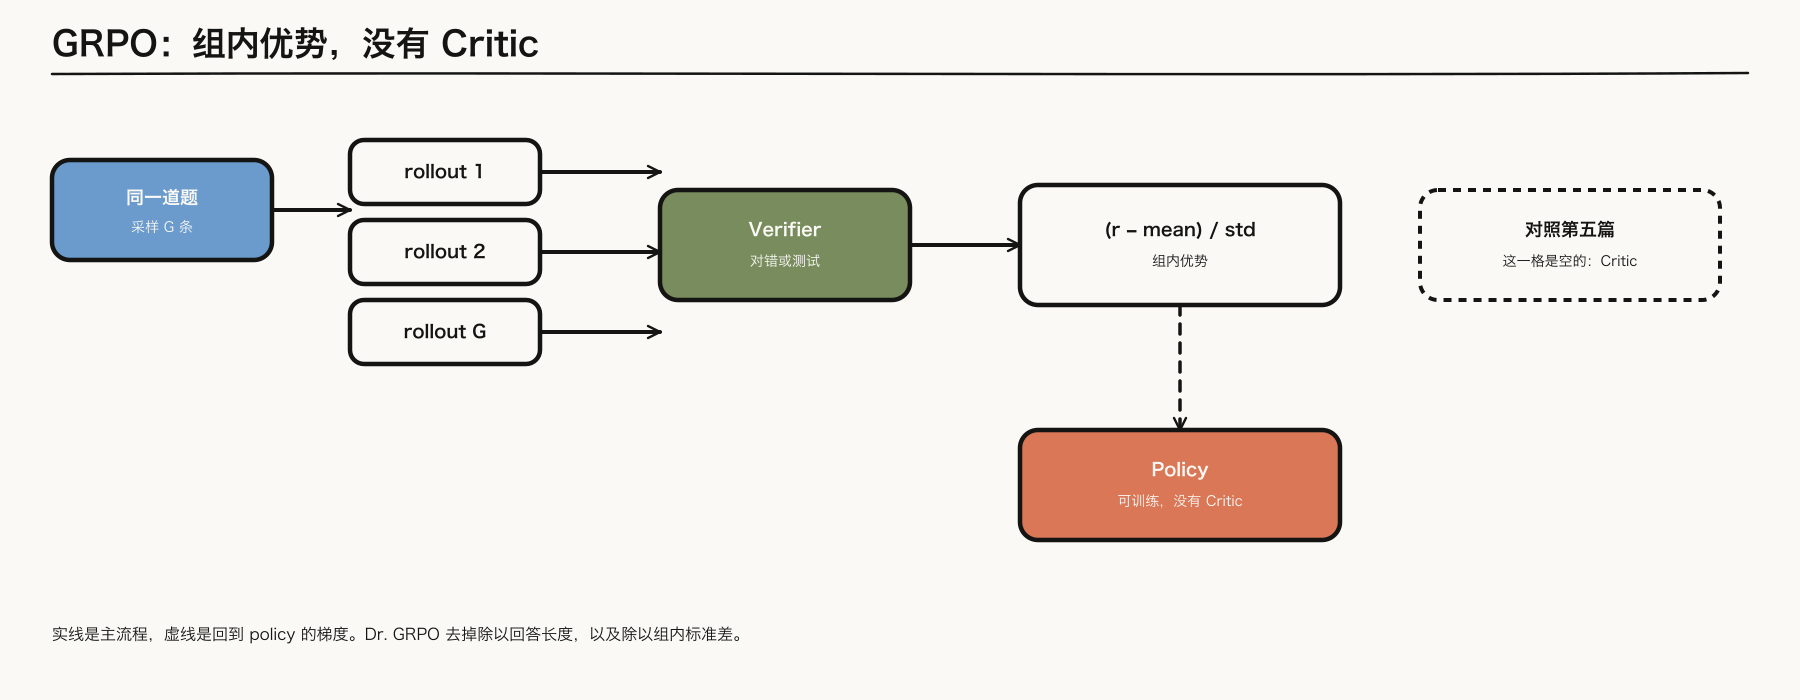
图 1:实线是主流程,虚线是回到 policy 的梯度,与第二篇图 1、第五篇图 1 一致。和第五篇四模型图比,少的是 Critic。Verifier 是规则,不是 RM。
DeepSeekMath 的 GRPO 仍把相对 reference 的 KL 加在损失里。第五篇的 PPO-RLHF 通常把 KL 折进奖励。DAPO 说「去掉 KL」时,去掉的是 GRPO 损失里的那一项,不是第五篇奖励里的那一项。两处不是同一个开关。
组内优势可以写成。均值和标准差都在同一道题的 \(G\) 条回答上算。
adv = (reward - reward.mean()) / (reward.std() + eps)
# Dr. GRPO:只减组内均值,不再除以标准差
adv = reward - reward.mean()
| 全对或全错时标准差接近 0,优势被放大;再除以回答长度时,做对的短回答梯度更大,做错的长回答罚得更轻。Liu 等 把这两处叫做问题难度偏差和回答长度偏差。Dr. GRPO 去掉 $$1/ | o | $$,也不再除以组内标准差。这和第二篇的 loss 归一化是同一类分母问题:分母若跟着样本长度走,日志里的长度变化不一定是「学会了反思」。 |
三、R1 是多阶段,不是一次 GRPO
R1-Zero 没有 SFT 冷启动,直接在 base 上做 RL。报告观察到反思和回溯。第一篇已经写过:这是那次运行的现象,不是保证。后面还有冷启动 SFT、推理 RL、拒绝采样、再 SFT、以及面向一般场景的 RL。公开配方是这几段接起来的,不是「纯 RL 就够了」。
DAPO 在 GRPO 上改了四件事:去掉损失里的 KL,采样时丢掉整组全对或全错的题,clip 的上下界解开,policy gradient 按 token 而不是按整段平均,超长样本另作处理。GSPO 再改重要性采样的层级:token 级比值的方差会沿长序列累加,MoE 的路由波动会把它放大;序列级比值修的是这个方差,不是笼统的「长序列更难」。
四、三种失控,和两组互相不判死的证据
KL 爆炸时,先看 KL 是加在损失里还是已经折进奖励。DAPO 去掉的是前者,于是要靠 clip、动态采样和长度处理挡住漂移,而不是把系数调小。
熵坍缩时,策略收成少数几种解法。pass@1 可以暂时还在,pass@k 先掉。Yue 等 报告:若干 RLVR 运行之后,大 \(k\) 下的 pass@k 回到 base,并据此质疑 RL 是否扩大了推理边界。ProRL 用更长的训练、KL 和周期性重置 reference,声称边界可以被推开。两组证据并列。这一篇不把其中一组写成定论。
长度膨胀时,奖励不罚长度,CoT 变长,正确率不一定升。Dr. GRPO 说明其中一部分是目标函数的分母,不是能力出现的标志。
还有一层更靠前的混淆。有工作报告,随机甚至错误的奖励也能让部分 Qwen 数学设置涨分。Wu 等 把这类现象收成条件:base 在该任务上的 pass@k 已经很高时,弱奖励或假奖励更容易看起来有效;对齐弱的时候,这些做法带不动,标准 RL 仍然有差。所以一份涨分要先对 base 家族和 pass@k 做对照,再记到奖励设计头上。这和第一篇的说法相同:评估是控制信号,不是事后的总分。
五、推理时的计算是另一笔账
训练若把可搜索的策略放进模型,推理时可以用更长的思考、多次采样或投票换正确率。多数投票、self-consistency 和过程搜索花的计算不一样,也不能互相代替。用预算强制停或继续想,改的是推理侧。没有公开训练配方的模型,不把它们的推理界面写成训练步骤。
六、交出去的是带验证器的策略
- 可验证奖励换掉的是 RM,没有换掉信用分配。
-
GRPO 的优势来自组内统计。$$1/ o \(和\)\mathrm{std}$$ 是两处会把长度和难度写进梯度的分母。 - KL 在 GRPO 的损失里,和在 PPO 奖励里,不是同一个开关。
- pass@1、pass@k 和回答长度要一起看。假奖励能不能涨分,先看 base 的 pass@k。
下一篇把这一次解答换成环境里的一串动作。奖励更晚才出现。