第四篇的结尾是:偏好优化需要的是同一套模板下的 chosen 与 rejected,或者好/坏标签,以及产生它们时的 policy 版本。那不是 SFT 的损失。这一篇从这份输入写起:先问偏好在假设什么,再问奖励和 KL 分别由哪个模型提供,最后问怎样知道这个奖励没有在奖励长度。
可验证的对错、环境里的轨迹,分别留在后面两篇。
范围:文本模型的偏好优化。对照 InstructGPT 的 PPO、Llama 3 的 DPO,以及 Tulu 3 的长度归一化。报告没写的系数不补。
一、成对偏好假设了一个标量奖励
把「\(y_w\) 比 \(y_l\) 更好」写成 Bradley-Terry:
\[P(y_w \succ y_l \mid x) = \sigma\big(r(x,y_w) - r(x,y_l)\big)\]这里的 \(r\) 是一个标量。它假设偏好可传递:若 A 胜 B、B 胜 C,则 A 应胜 C。循环偏好放不进这一个数。多个候选的排序可以写成 Plackett-Luce,仍是同一个标量奖励的排序模型。
Gao 等把过优化写成一条曲线:策略在 RM 上的分数可以随 KL 继续涨,人的偏好先升后降。所以 RM 的训练准确率不是上线指标。后面用三件事情核对一份 RM:留出偏好对上的准确率,RewardBench 这类公开基准,以及分数和回答长度的相关性。长度偏差在验证侧是这张相关性,在损失侧是下一节的长度归一化。两处各管一段。
二、PPO:四个模型,两条冻结
KL 约束下的目标是
\[\max_{\pi}\ \mathbb{E}_{x,y\sim\pi}\big[r(x,y)\big] - \beta\,\mathrm{KL}\big(\pi(\cdot\mid x)\,\|\,\pi_{\mathrm{ref}}(\cdot\mid x)\big)\]InstructGPT 把它拆成三步:SFT、用成对偏好训 RM、再用 PPO 更新策略。PPO 这一步同时在跑四个模型。
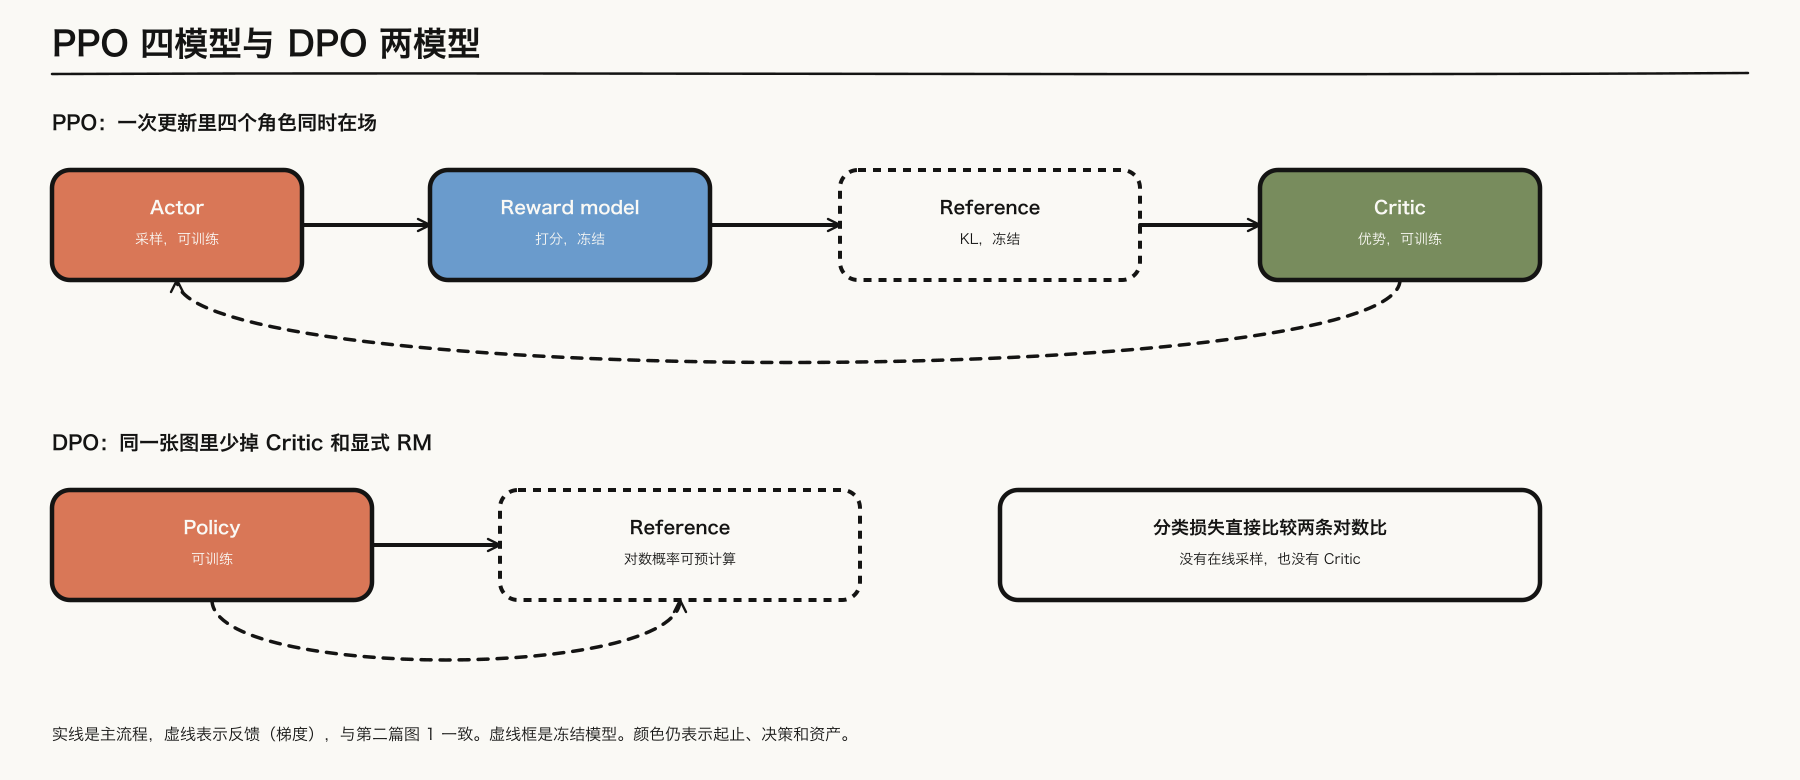
图 1:上排是 PPO,下排是 DPO。实线是主流程,虚线表示反馈(梯度),与第二篇图 1 一致。虚线框是冻结模型。上排的虚线只画回到 Actor 的策略梯度;Critic 用价值损失单独更新。颜色仍表示起止、决策和资产。
Actor 采样,Reward model 打分,Reference 提供 KL 里的旧策略,Critic 把回报变成优势。常见写法把 KL 折进奖励再交给 PPO,而不是像后面 GRPO 那样把 KL 单独加在损失里。Actor 和 Critic 更新,RM 和 Reference 冻结。KL 是约束策略不要离开 SFT 模型,不是损失上的装饰项。
三、DPO 消掉的是在线采样和显式 RM
在 Bradley-Terry 和上面的 KL 约束同时成立时,最优策略的奖励差可以写成 policy 与 reference 的对数比。于是成对偏好变成一个分类损失,RM 不必再单独训练,rollout 也不必在线采。Reference 的对数概率仍要,可以提前算好。
图 1 下排只留 Policy 和 Reference。少掉的是 Critic,以及那个显式的 reward model。分布偏移留在损失外面:偏好对若来自很旧的 policy,当前模型是在做离线分类,分类损失可以继续降,而新政策下的偏好不一定更好。这就是 Gao 那条曲线在没有 RM 时的对应物。
Azar 等指出另一处裂缝:偏好若是确定性的,Bradley-Terry 再推出 DPO,会把 chosen 与 rejected 的对数比推向无穷。IPO 用平方损失把这个比拉住,改的是 BT 到 DPO 的那一步,不是又一个采样技巧。
其余变体按「改了哪一项」放在一起。KTO 用不配对的好/坏标签,对应的是前景理论里的得失,不是 DPO 的成对形式。ORPO 把 SFT 和偏好合成 odds ratio,没有 reference。SimPO 去掉 reference,用序列上的平均对数概率当隐式奖励,并做长度归一化。Tulu 3 公开采用长度归一化的 DPO,针对的就是奖励和损失都偏向更长回答。
四、损失里那几行
当前 TRL 在 loss_type == "sigmoid"、散度为 reverse KL 时,先分别减去 reference 的对数概率,再把两条比相减。\(\beta\) 乘在这个差上,然后进 logistic。文件里还有 hinge、IPO 等分支,下面只是 sigmoid 这一支。
chosen_logratios = chosen_logps - ref_chosen_logps
rejected_logratios = rejected_logps - ref_rejected_logps
delta_score = chosen_logratios - rejected_logratios
per_sequence_loss = -F.logsigmoid(self.beta * delta_score)
同一文件里,IPO 分支会把平方损失再除以 completion 的 token 数。注释写明这不是 IPO 论文讨论过的形式,是为了让 \(\beta\) 在变长回答之间可比。长度从这里又进了一次分母。
chosen 与 rejected 必须是同一套 chat template 渲染的。格式 token 若留在两条序列里,模型会同时被要求提高和降低它们的概率。Llama 3 因此在 DPO 损失里 mask 掉 header 和终止符。这和第四篇是同一件事:模板 token 进不进 \(\mathcal{T}\),要单独声明。
他们还在 chosen 序列上加了一项 NLL,系数 0.2,用来挡住 chosen 的对数概率在对比学习里下降。于是这一阶段的总损失里,第四篇的 SFT 项和这一篇的偏好项同时在,系数是报告里的 0.2。
五、六轮本身就是迭代
Llama 3 最大模型的 DPO 学习率是 \(10^{-5}\),\(\beta = 0.1\)。偏好数据主要来自上一轮表现最好的模型,所以每轮都比一份固定的离线集更靠近当前 policy。他们试过 PPO,报告里的结论是:大规模上 DPO 更省计算,在 IFEval 上更好。后训练共六轮,每轮是 SFT 再 DPO。这就是 online / iterative DPO,不必另起一个算法名。
Constitutional AI 用书面原则让模型生成和修改偏好,奖励信号来自模型而不是环境验证器。那是 RLAIF 的一条路径。规则能判对错的题目,留到下一篇。
六、交出去的是带偏好的策略,还不是可验证的推理
- 偏好模型的假设决定了后面能用哪一个损失。BT 推不出 IPO 要修的那种确定性偏好。
- PPO 里 Actor 和 Critic 更新,RM 和 Reference 冻结。KL 在这套写法里折进奖励。
- DPO 省掉的是在线采样和显式 RM,不是 reference 的对数概率。
- 长度偏差分两处查:RM 分数与长度的相关性,以及损失里的长度归一化。
下一篇从这里接:当奖励可以由验证器给出时,学出来的 RM 不再是必要的。