第二篇在学习率日程那一节留了一个结:常数平台的价值,是把「何时开始衰减」的决定往后推;而衰减一旦开始,数据改动和日程改动就缠在一起。本篇就发生在这个窗口附近——模型主干已经训完或接近训完,post-training 还没开始,中间这段仍然用语言建模目标做的继续训练,就是第一篇操作性定义过的 mid-training。论文里它可能叫 annealing、continued pretraining 或 context extension,名字不重要,动的分布才重要。
这一段里通常发生三类事:把高质量数据的采样权重抬高(退火升配),用领域语料继续预训练(领域续训),把序列长度从几 K 拉到上百 K(长上下文扩展)。三类操作动的是三个不同的分布——质量与领域配比、整个语料分布、位置分布——目标函数的形式仍是下一个 token 的负对数似然。这里说的「监督位置没变」,指主干仍对序列里的 token 全算 loss。MiniCPM 把 SFT 风格数据放进 decay,OLMo 2 的 Dolmino 里有 FLAN;公开报告没有写明这些样本是整段都算 loss,还是只算 response。若已经只训 response,它在语义上就是 SFT,只是还挂在同一个学习率日程上。这个边界是第四篇的起点,不是阶段名能决定的。
分布式与显存仍然不在这里重讲。《并行策略到底在切什么》已经写过长序列把 activation 和 attention 显存推向哪里;本篇只在长上下文一节引用它。
范围:文本 LLM 的 mid-training,对照 Llama 3、DeepSeek-V3、OLMo 2、MiniCPM 与 DeepSeekMath 的公开配方。SFT 数据、偏好数据留在后面对应篇目。数字都标明出处;报告没写的不补。
一、三个旋钮,不是一个「退火魔法」
把 mid-training 说成「退火涨点」是把三个决策压成了一个词。先拆开:
| 操作 | 改变的分布 | 不变的 | 公开参照 |
|---|---|---|---|
| 退火升配 | 数据质量与领域配比 | 目标函数、tokenizer、架构 | Llama 3、MiniCPM、OLMo 2 |
| 领域续训 | 整个语料分布 | 目标函数、架构 | DeepSeekMath |
| 长上下文 | 序列长度与位置分布 | 目标函数、数据主体 | Llama 3、DeepSeek-V3 |
三个旋钮可以组合,但消融要分开做。第一篇要求数据系统保留来源、领域、质量、长度标签,就是为了这一刻:同一池原料,退火时按质量标签重配,续训时按领域标签重配,长上下文时按长度标签取出当初没被切碎的整篇文档。标签没留,这三个旋钮就都拧不动。
公开预算不是一个点。OLMo 2 把这一段写成大约占训练 FLOPs 的 5%–10%。Llama 3 405B 的长上下文阶段约 800B token,相对 15.6T 大约 5%。DeepSeek-V3 的上下文扩展是 11.9 万 / 266.4 万 H800 GPU 小时,不到 5%。这几段换分布或换长度的预算,落在大约百分之一到一成。405B 把学习率收到 0 的正式退火只有最后 40M token,约 0.26%,在这个区间下面:它不再教一段新分布,只是把最后的 checkpoint 收住,所以可以再短一个数量级。
先解第二篇留下的那个结。
二、同一段曲线上,学习率和数据各自在做功
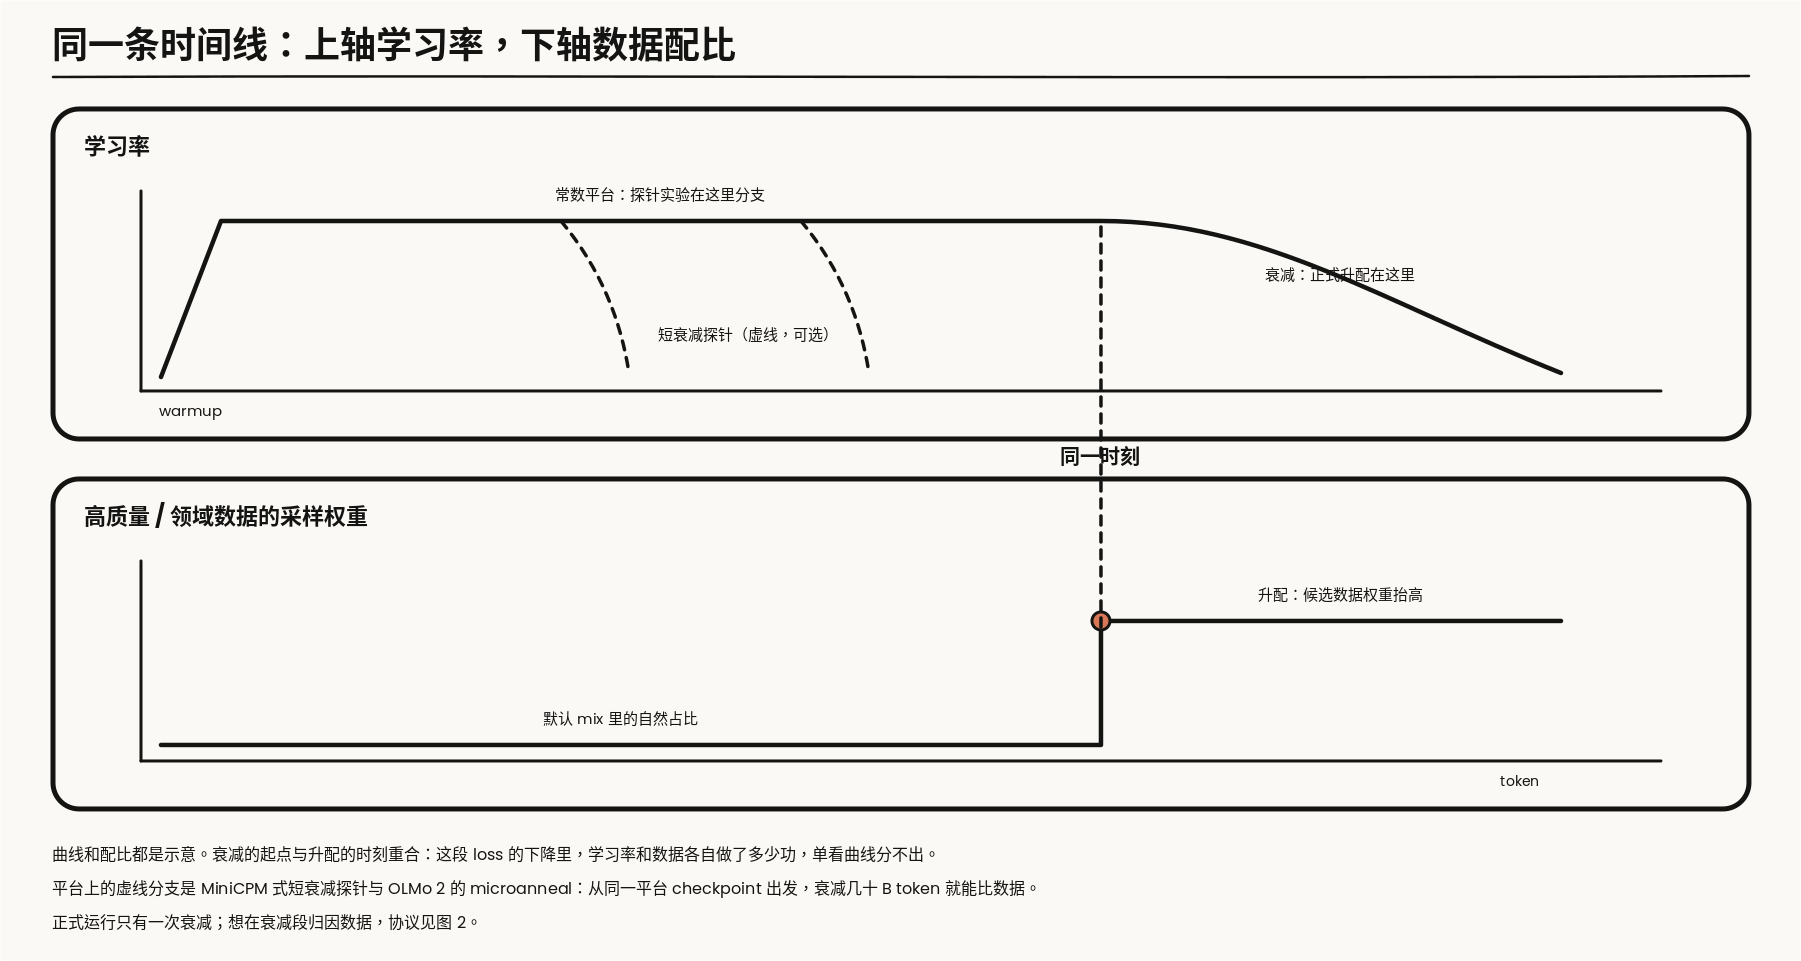
图 1:上轴是学习率,下轴是数据配比,两轴共用同一条时间线。曲线与配比都是示意;要点只有一个——升配的时刻和衰减的起点重合,单看 loss 曲线分不出谁在做功。
MiniCPM 把 WSD 日程的 decay 段讲清楚了两件事。第一,loss 在进入衰减后快速下降——这件事学习率自己就能解释,和数据无关。第二,他们把高质量数据和 SFT 风格的数据加在 decay 开始处,比把同样的数据全部留到 SFT 阶段更有效。两个效应叠在同一段曲线上:你看到 decay 段 loss 掉得很快、下游也在涨,但涨点里有多少来自数据、多少来自学习率,曲线本身不回答。这就是第二篇说的缠绕。
解缠绕靠协议,不靠辩论。Llama 3 的做法是把退火本身改造成探针:取一个训练到 50% 进度的 8B checkpoint,用 40B token 把学习率线性降到 0,候选数据占 30%、默认 mix 占 70%;对照组用完全相同的日程和 token 数,只是数据换成 100% 默认 mix。同一套冻结评测集下比较,差值就是这份数据在这个日程下的价值。Blakeney 等把同类操作总结为「训练末段的领域升配评估」。
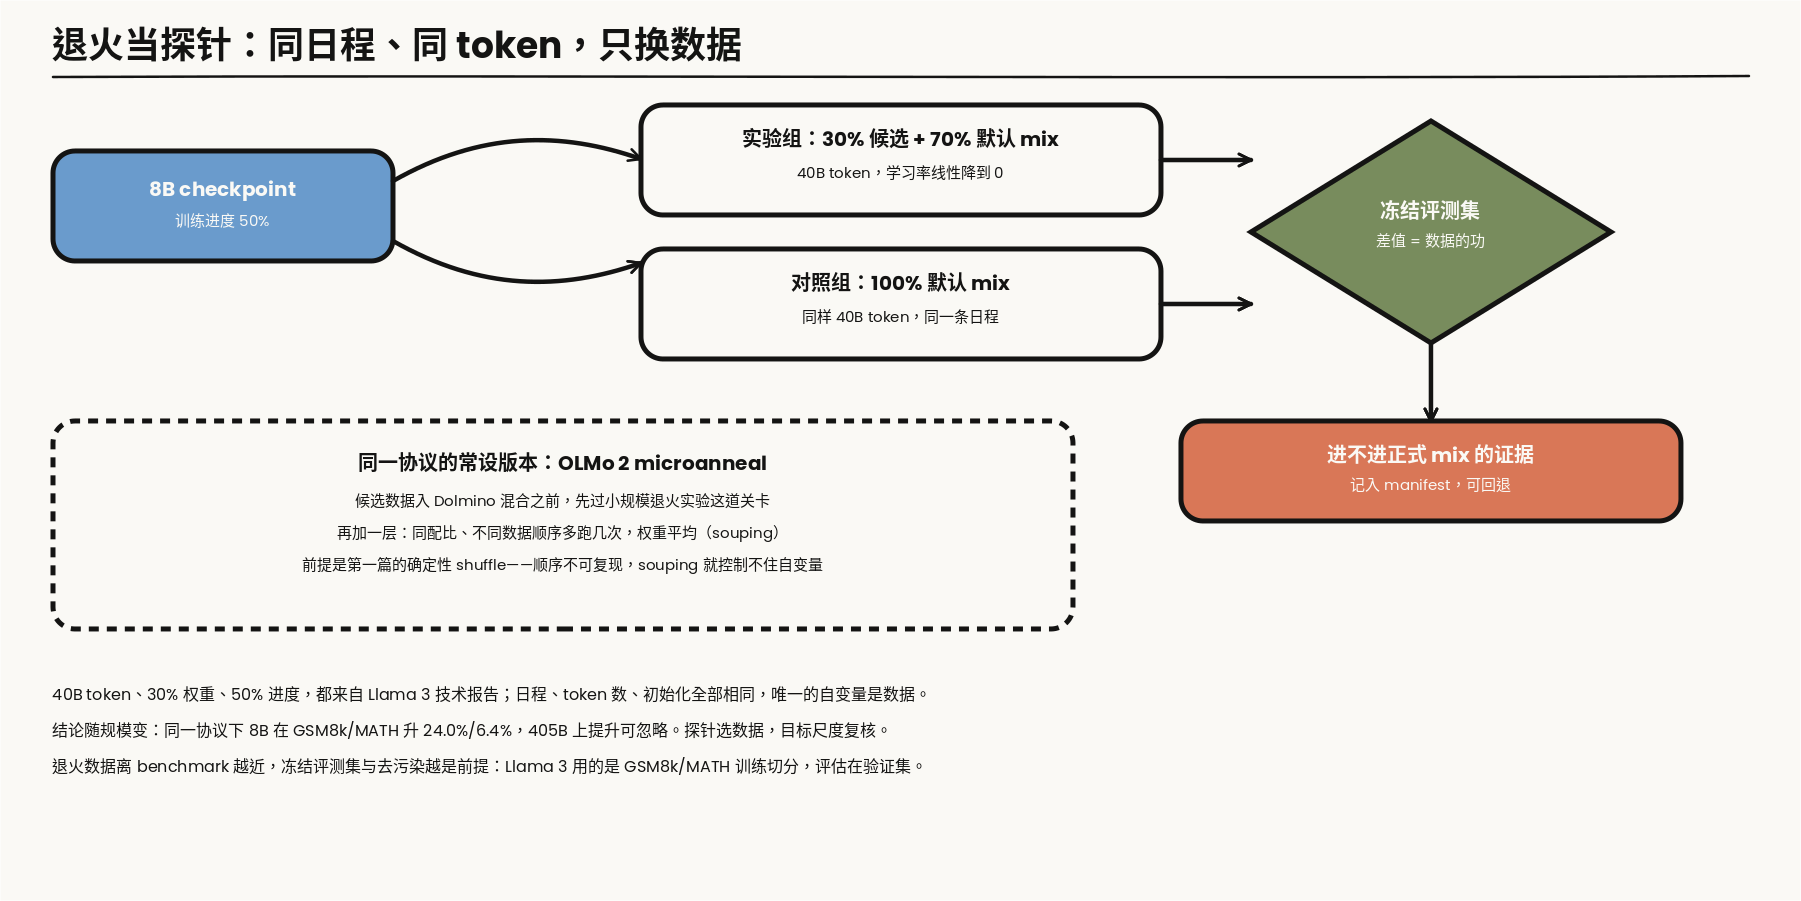
图 2:Llama 3 的退火探针协议。40B token、30% 候选权重、50% 训练进度,都来自技术报告;对照组与实验组唯一的差别是数据。
这个协议回答了第二篇结尾的问题——数据实验在常数段做还是衰减段做:短衰减从平台或中途 checkpoint 分出来做,正式升配放在衰减段。 WSD 的常数平台意味着可以从同一个平台 checkpoint 分出多个短衰减分支,每个分支试一种数据,成本是 40B token 一次而不是重训一次;MiniCPM 正是用这种「平台分支 + 短衰减」把原来要全程重训的实验变便宜的。Llama 3 的 40B 探针不是在常数学习率上训,它本身就是一次降到 0 的短衰减,起点是训到 50% 的 checkpoint。正式运行里,高质量数据放在衰减段抬权重,MiniCPM、Llama 3、OLMo 2 的公开配方都是这么做的。
另一组实验回答的是另一个问题:如果退火数据就贴着 benchmark,会发生什么。Llama 3 把 GSM8K 和 MATH 的训练集放进退火,8B 的验证集分别涨 24.0% 和 6.4%,405B 上可以忽略。它说明退火会放大邻近数据的价值,也说明同一份做法的收益可以随规模归零。40B 探针只在 8B 上做过,没有这组 405B 对照。拿 8B 上任何一组退火结论直接改 405B 的配比,都等于没做实验。
报告写明,正式退火数据不含常用 benchmark 的训练集。上面这组是故意把这条线踩一遍,用来看踩了会怎样:训练集进退火,验证集上评估。退火数据离 benchmark 越近,第一篇的冻结评测集、按重复簇划分 holdout、每轮重跑去污染,就越是前提而不是形式。在衰减段抬高 benchmark 邻近数据的权重,是涨点最快的手段,也是评测失真最快的手段。
三、把 mid-training 做成制度:OLMo 2 的可复现版本
OLMo 2 干脆把这一段变成正式的第二阶段:主干先在通用混合上训练,然后切换到 Dolmino 混合做 mid-training——过滤后的高质量网页、指令风格的 FLAN 文本、合成数学数据、百科与学术文本——学习率在这一段内线性降到 0。7B 的 mid-training 预算是 50B token,13B 用到 100B 与 300B 的组合。相比 Llama 3 只在报告里给出协议,OLMo 2 连数据、checkpoint 和配比一起公开,是三家里唯一能逐步照抄的。
它有两个工程细节比配比本身更值得搬走:
- 数据决策常设化。候选数据先过 microanneal——小规模退火实验——再决定进不进 Dolmino。这和第二节的探针是同一思路,区别是它不是论文里的一次性实验,而是数据入池的例行关卡。
- 对数据顺序做平均。同一配比、不同数据顺序多跑几次 mid-training,把得到的权重做平均(model souping)当最终 checkpoint。这件事的前提是第一篇的确定性 shuffle 和可重放的 sample order:顺序不可复现,几次运行就不是「同配比不同顺序」,souping 连自变量都控制不住。
这一节的功能是给个参照系:mid-training 不必是正式运行前临时起意的「最后冲刺」,它可以是有入池标准、有重复实验、有版本记录的常设阶段。
四、领域续训:起点、配比、防遗忘
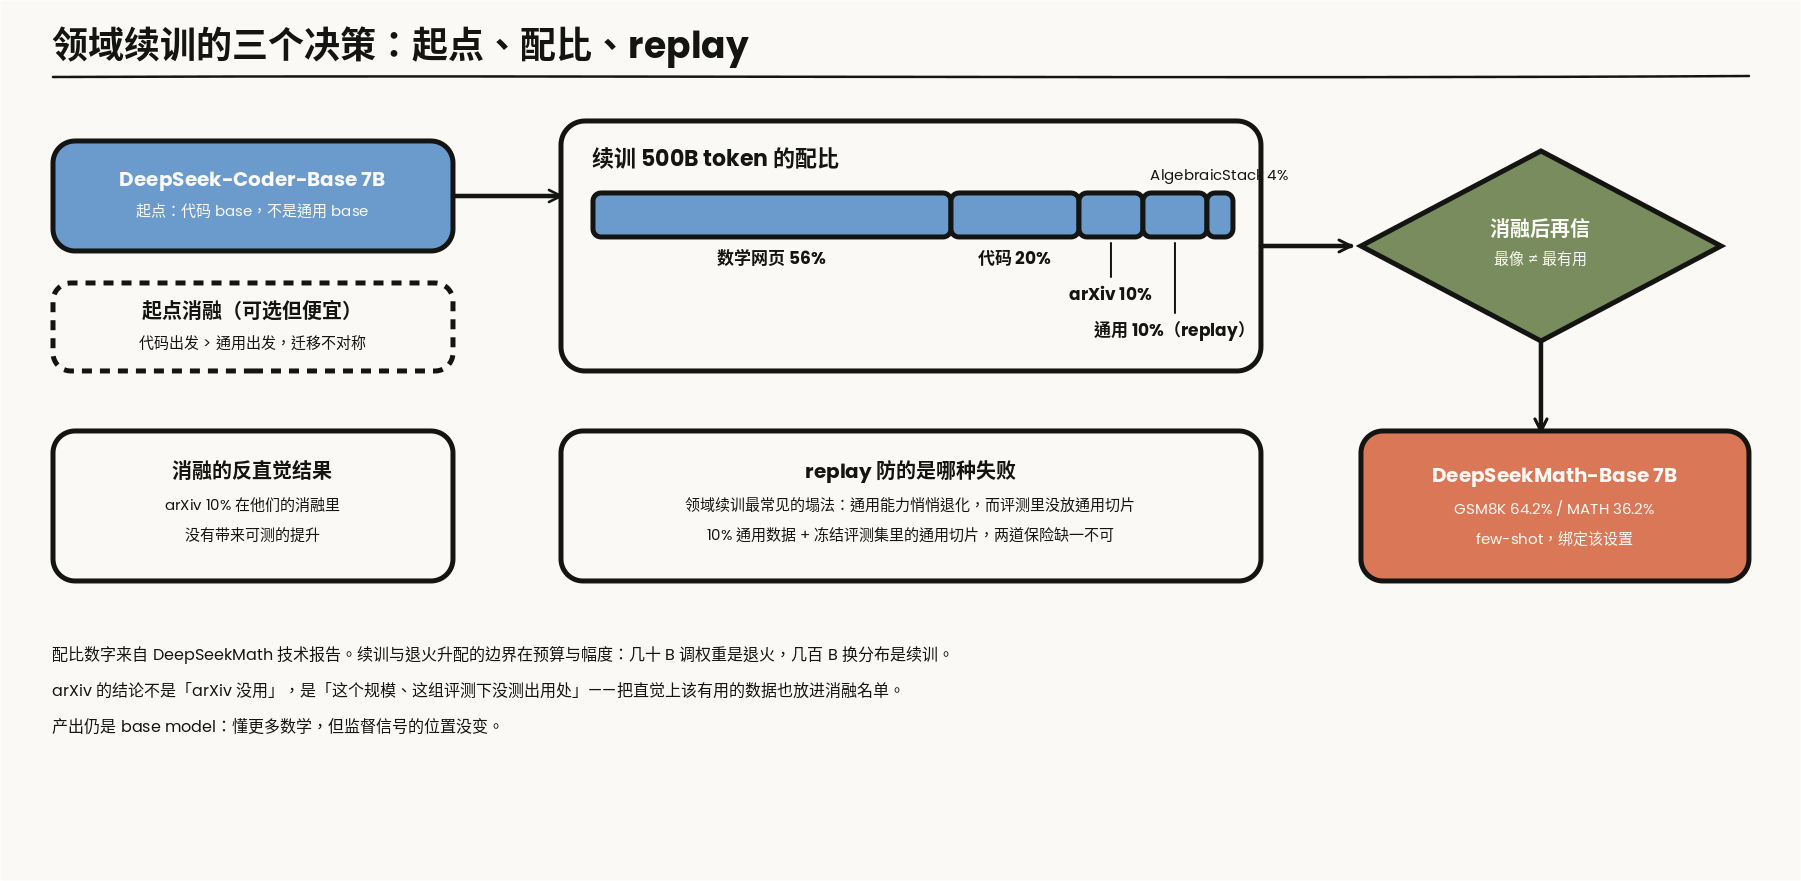
图 3:DeepSeekMath 的续训配方。配比数字来自其技术报告;通用数据那一段是刻意保留的 replay,不是没洗干净的杂质。
领域续训和退火升配的边界在预算和幅度:退火用几十 B token 调权重,续训用几百 B token 换掉整个分布。DeepSeekMath 是公开案例里写得最完整的一个:从 DeepSeek-Coder-Base-v1.5 7B 出发续训 500B token,配比是 56% 数学网页语料、20% GitHub 代码、10% arXiv、10% 通用自然语言、4% AlgebraicStack。它的三个决策对应领域续训的三个通用问题。
起点。他们的消融里,从代码 base 出发学数学,好于从通用 base 出发。领域之间的迁移不对称,起点不是「找个最新的通用模型」这么显然,值得用小规模消融先验证。
配比。56% 不是「越纯越好」的结果。通用自然语言占 10%,代码占 20%。论文明确写的是:把代码 token 留在续训里,HumanEval 和 MBPP 能保住;那 10% 自然语言被列为配比的一部分,报告没有单独把它写成防遗忘实验。领域续训最常见的失败仍然是通用能力悄悄塌掉,而评测里恰好没放通用切片。要一个数,而不是「看一看」:在冻结的通用集上算 backward transfer(续训后减去续训前),并在同一批通用 token 上算续训后模型相对 base checkpoint 的 KL。掉 0.5 个点和掉 5 个点会导向不同的 replay 比例。
验证反直觉。arXiv 论文在他们的消融里没有带来可测的提升。这不是「arXiv 没用」的普适结论,而是「在这个规模、这个 tokenizer、这组评测下没用」;但它足够说明问题——不做消融,你会把长得最像数学的数据当成最有用的数据。最像和最有用之间隔着一次受控实验。
这份配方的产出是 DeepSeekMath-Base 7B:GSM8K 64.2%、MATH 36.2%(few-shot)。数字绑定它的设置,搬走的应该是决策结构:起点消融、replay 配比、以及把「直觉上该有用的数据」也放进消融名单。
五、长上下文:位置分布的续训
长上下文几乎总是放在整个预训练的最后,对 Llama 3 和 DeepSeek-V3 是一笔很直接的账:稠密 attention 里有一项随序列长度平方增长,训练序列从 4K 拉到 128K,这一项涨约三个数量级;而绝大多数训练价值仍来自普通长度的文本。DeepSeek-V3 的账本里,上下文扩展用了 11.9 万 H800 GPU 小时,不到预训练 266.4 万的 5%——只有放在最后、用少量 step 做,这笔钱才是这个数量级。这笔账假设每层都做稠密 attention。2025 年的公开模型已经把这个前提拆开:MiniMax-01 混入线性注意力,Nemotron-H 混入 Mamba,Llama 4 使用交替注意力和 iRoPE。序列长度的成本不再自动是 \(S^2\)。稠密长上下文仍然贵,所以上面两家仍把它放在最后;混合注意力怎么改这笔账,见《512K 上下文的全参 SFT》。
机制可以一段讲完。RoPE 给第 \(i\) 对维度的旋转角频率和波长是
\[\theta_i = \mathrm{base}^{-2i/d}, \qquad \lambda_i = \frac{2\pi}{\theta_i}\]波长超过训练长度的那些维度,在训练长度内转不满一圈,外推时最先出问题。Llama 3 的 8B、70B、405B 在架构表里都把 RoPE base 固定为 500,000。报告只说这个值有助于支持更长上下文,并引用 Xiong et al. 在 32,768 长度上的结果;「为后面的扩展留余量」不是报告里的表述。把 base 调大,是把角频率调低、波长调长,超过训练长度的维度会更多,不是把波长缩回训练长度以内。下面的代码可以把这件事数出来。Position Interpolation 是另一条路:把位置 \(m\) 换成 \(m/s\),把长序列压回训练过的位置区间,代价是短程分辨率。YaRN 按波长分组——转得快的维度不动、从没转满的维度做插值、中间平滑过渡——再给注意力加温度:\(\sqrt{1/t} = 0.1\ln(s)+1\)。工程上把这个因子同时乘进 query 和 key 的 RoPE 缓存,等效于把 logits 乘上 \(1/t = (0.1\ln s+1)^{2}\)。判断自己的模型哪些维度在外推,一段代码就够:
import numpy as np

def rope_wavelengths(d_head=128, base=500_000.0):
    i = np.arange(0, d_head, 2)
    theta = base ** (-i / d_head)   # 每对维度的角频率
    return 2 * np.pi / theta        # 波长:转满一圈需要的 token 数

wl = rope_wavelengths()
print((wl > 8192).sum(), "/", wl.size, "维度在 8K 训练长度内没转满一个周期")
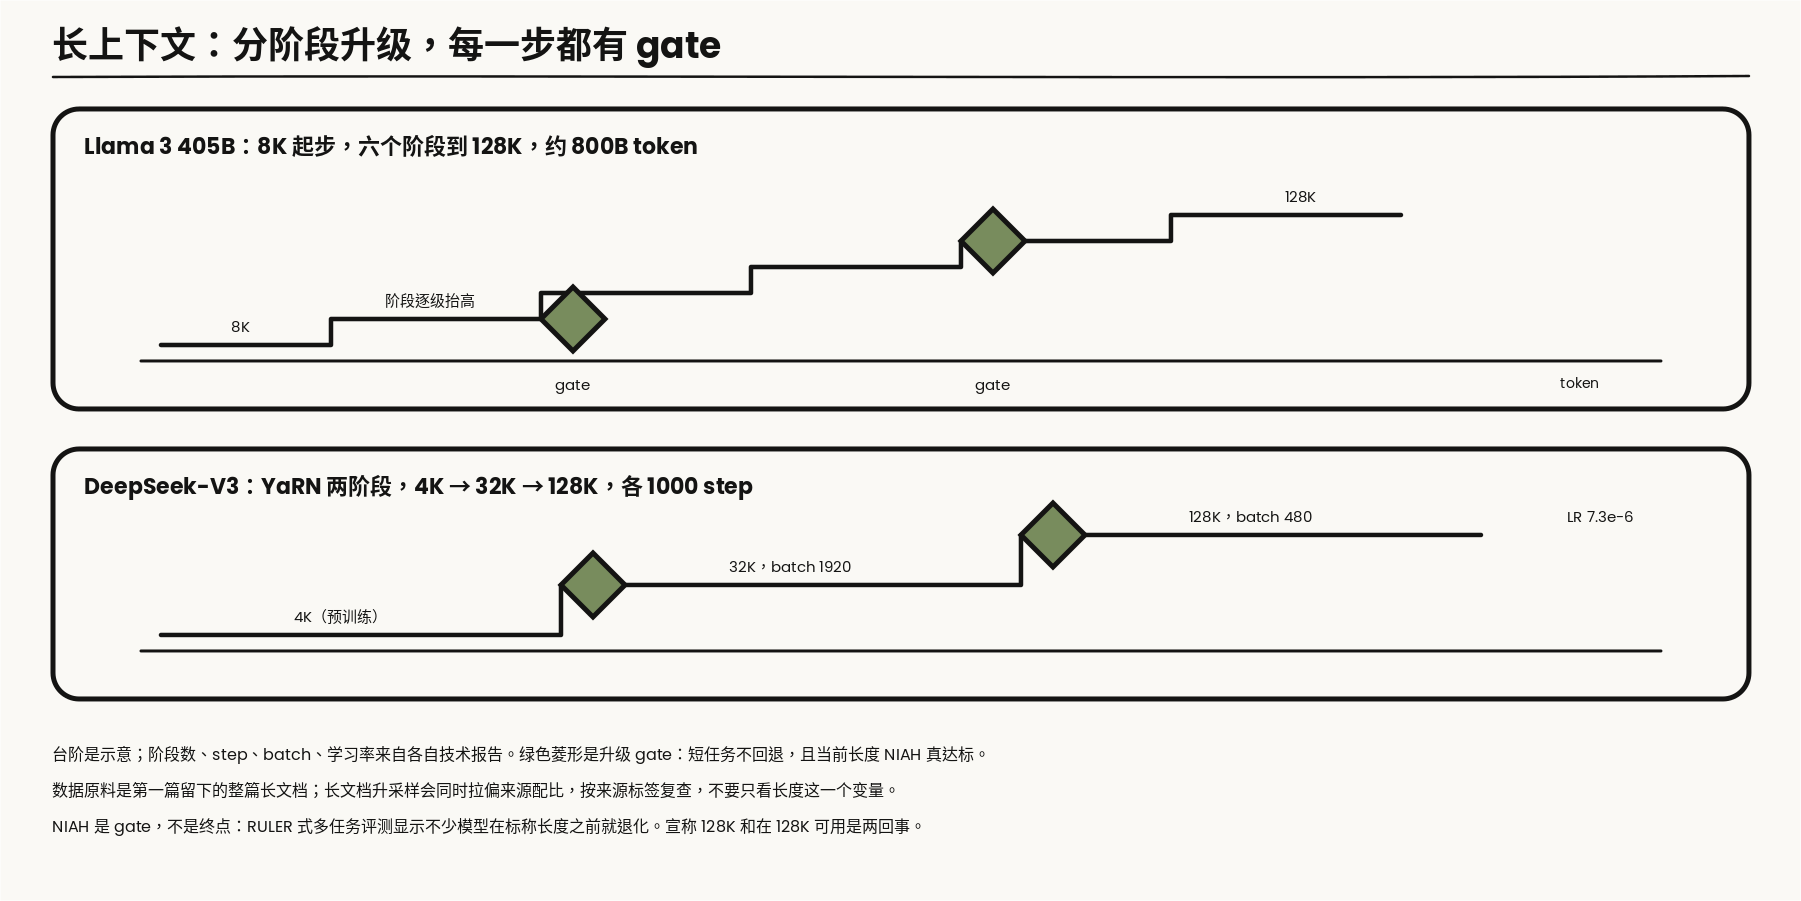
图 4:台阶是示意;阶段数、step、batch 和学习率来自各自的技术报告。绿色菱形是升级 gate:短任务不回退,当前长度的检索真达标。
两套公开路径的形状不同,纪律相同:
| Llama 3 405B | DeepSeek-V3 | |
|---|---|---|
| 路径 | 8K 起步,六个阶段升到 128K | 4K → 32K → 128K,两个阶段 |
| 方法 | 调大 RoPE base 后分阶段续训 | YaRN |
| 规模 | 约 800B token | 每阶段 1000 step,batch 1920 / 480 |
| 学习率 | 未单独写明 | 7.3e-6,等于预训练末端的学习率 |
| 升级条件 | 短任务表现完全恢复,且当前长度 NIAH 全对 | 报告展示 128K NIAH 结果稳定 |
数据这一侧,第一篇 4.14 节的伏笔在这里兑现:长上下文阶段需要的是当初没有被切碎的整篇文档。如果数据系统只落了 4K 的 chunk,这一步就没有原料,回头重新解析的成本远高于当初多存一份。长文档升采样还会带来一次隐形的配比改动,下一节单独讲。
序列拉长之后 activation 显存、attention 矩阵和并行怎么重排,是并行那篇的内容,不重讲。
六、升级失败时,先分清三对容易混淆的信号
第二篇给 loss spike 画了诊断分支;mid-training 的故障没有那么戏剧性——曲线通常很平,坏消息藏在评测切片里。这一节把三对最容易互相顶替的信号拆开。排查的前提仍然是第一篇的基础设施:冻结评测集有通用切片,manifest 能回答「这一段训练喂了什么」。
6.1 短任务回退:先分「位置的锅」还是「数据的锅」
长上下文阶段做完,MMLU 或 GSM8k 这类短任务掉了几个点。两个嫌疑人的作案方式完全不同,排查顺序也不该一样。
位置这条线,症状有指纹。Position Interpolation 的论文自己写了代价:把位置压回 \(m/s\) 之后,原训练长度内的 PPL 会轻微上升——短程的位置分辨率被插值稀释了。如果回退集中在对位置敏感的任务(代码补全、多步算术这类依赖 token 间精确相对位置的任务),且回退幅度随扩展比例 \(s\) 单调变大,先查位置侧:插值比例是不是一步跨得太大,YaRN 的温度项有没有加。这条线的检验很便宜——不动权重,只把推理时的 RoPE 配置换回扩展前的版本,在短序列上重测一遍。分数回来了,就是位置的锅。
数据这条线,症状没有指纹,要靠账本。长上下文阶段的 mix 往往同时动了两件事:序列变长,长文档被升采样。回退如果分布在所有短任务上、和位置敏感度无关,嫌疑就移到配比——书籍和论文挤掉了原 mix 里的指令风格文本和短网页。这时候位置侧怎么调都不会好,要回 manifest 看这一段的来源分布和主干阶段差了多少。
Llama 3 把「短任务表现完全恢复」设成每一级的升级 gate,等于强制在每个台阶上把这两个嫌疑人都审一遍,而不是六级跳完才发现回退、再去猜是哪一级引入的。这是分阶段比一步到位多出来的信息量,不只是稳定性。
6.2 长文 PPL 在降,不等于长上下文在工作
长上下文训练里最便宜的指标是长文档上的验证 PPL,它也几乎总在下降。但 PPL 是全位置平均:一篇 64K 的文档,绝大多数 token 用局部几百个 token 就能预测得不错,真正需要跨几万 token 检索的位置占比很小。模型完全可以靠「局部建模变好」把 PPL 压下去,而 128K 处的检索能力没有建立——PPL 降、NIAH 不过关,两个信号背离时,信 NIAH。
反过来的背离也存在,而且更隐蔽:NIAH 全绿、实际长任务不行。RULER 的结论就是这个——把任务从单针检索换成多针、聚合、变量追踪,不少模型在标称长度的一半处就明显退化。所以第五节说 NIAH 是 gate 不是终点:它适合做「这一级能不能升」的快速否决,不适合做「128K 可用」的证明。两类信号在冻结评测集里都要有,位置也不同——NIAH 在循环里每级都跑,RULER 式评测在升级完成后做验收。
把这两条背离连起来,长上下文的评估纪律就一句话:PPL 用来看训练在不在正轨,NIAH 用来守升级的门,多任务长文评测用来宣称能力。三个各管一段,互相不能顶替。
6.3 长文升采样是一次隐形的 mix 改动
第五节末尾提过一句,这里把它展开成可操作的检查,因为它是三类故障里最容易漏的——它不报错,也不立刻掉分。
按长度筛选文档,等于按来源重新抽样:长文档高度集中在书籍、论文、代码仓库这几类来源,短网页、对话、问答天然进不了长上下文池。于是「把序列拉到 128K」这个动作悄悄携带了一次领域配比改动——和第四节的领域续训做的是同一类事,区别是没人在配方里写它。如果长上下文阶段之后通用能力下滑,而你只在位置编码上找原因,就会一直找不到。
检查本身不贵,用第一篇的标签做两张对照表就够:这一阶段实际消费的 token 按来源和按领域各切一刀,和主干阶段的分布并排放。偏移大的桶,两个处理方向都是现成的——要么把该来源的短文档拼接成长序列补回去(packing 本来就支持),要么接受偏移、但把对应领域的回归评测加进这一级的 gate。选哪个是配方决策;不看这张表就升级,是流程缺陷。
这三类检查没有一个需要新工具,全部落在第一篇已经要求的资产上:标签、manifest、冻结评测集的切片。Mid-training 的故障排查之所以显得「没有方法论」,多数时候只是因为这三样在开训时没有留。
七、交出去的仍然是一个 base model
Mid-training 结束,模型仍然在续写——它比第二篇结尾那个 base 懂更多数学、见过更长的文档。只要 loss 仍铺在全部 token 上,监督位置就还没变。一旦某段数据只训 response,阶段名即使仍叫退火,语义上已经是 SFT。下一篇从 mask 的位置开始,不从阶段名开始。
这一篇该留下的判断标准有五条:
- Mid-training 是三个独立旋钮——质量配比、领域分布、位置分布——各自有各自的消融方式。不要用「退火」一个词把它们混成一次操作。
- 归因的最小协议是:同日程、同 token、同初始化,只换一个因素。Llama 3 的 40B 探针和 OLMo 2 的 microanneal 都是这个协议的实例。做不到就不要下数据结论。
- 两组实验不能互相引用。报告里把 GSM8K 和 MATH 的训练集放进退火,8B 验证集上升 24.0% 和 6.4%,405B 上可以忽略;这组实验不是前面的 40B 探针,正式退火也不含这些训练集。
- 长上下文的三个指标各管一段:PPL 看训练在不在正轨,NIAH 守每一级升级的门,多任务长文评测负责宣称能力。互相不能顶替。稠密 attention 的 \(S^2\) 账只覆盖 Llama 3 和 DeepSeek-V3 这条路径。
- 升级失败先分锅:位置的锅有指纹(位置敏感任务、随扩展比例单调、换回旧 RoPE 配置可复测),数据的锅靠账本(manifest 里的来源与领域对照表)。每一步的 checkpoint 和数据版本都要能指回第一篇的 manifest。
SFT 要问的第一件事,是这份数据的 loss 铺在全部 token 上,还是只铺在 response 上。第一篇预留的 messages、role 和 loss mask,到那里才第一次决定梯度从哪些位置回来。
参考资料
- Llama 3 Herd of Models(退火探针协议、长上下文六阶段)
- DeepSeek-V3 Technical Report(YaRN 两阶段扩展、算力账本)
- OLMo 2(Dolmino mid-training、microanneal、model souping)
- Hu et al., MiniCPM(WSD 日程与 decay 段数据实验)
- Shao et al., DeepSeekMath(领域续训配比与消融)
- Blakeney et al., Does your data spark joy?(训练末段领域升配评估)
- Su et al., RoFormer(RoPE)
- Chen et al., Position Interpolation
- Peng et al., YaRN
- Hsieh et al., RULER(长上下文有效长度评测)
- MiniMax-01 / Nemotron-H(混合注意力,改写 \(S^2\) 成本)